Guía de investigación e implementación para pruebas autónomas de seguridad en aplicaciones web y API externas
Las pruebas de penetración autónomas están evolucionando desde el escaneo convencional de vulnerabilidades hacia sistemas capaces de descubrir la superficie de ataque de una aplicación, formular hipótesis sobre posibles debilidades, seleccionar pruebas apropiadas, interpretar resultados, adaptar sus siguientes acciones y validar las vulnerabilidades sospechosas mediante evidencia reproducible.
Sin embargo, existe una distinción fundamental que suele pasarse por alto: una herramienta de seguridad impulsada por inteligencia artificial no es necesariamente un pentester agéntico. Un escáner puede utilizar un modelo de lenguaje de gran tamaño (LLM) para explicar hallazgos o generar payloads y, aun así, seguir un flujo de trabajo fijo. Un sistema verdaderamente agéntico utiliza sus observaciones para decidir qué hacer a continuación, modifica su plan cuando la evidencia contradice sus suposiciones y reconoce cuándo debe detenerse.
Este artículo desarrolla una arquitectura orientada a la implementación para una plataforma de pruebas de penetración externas de caja negra en aplicaciones web. Abarca la arquitectura del sistema, el reconocimiento, el descubrimiento mediante navegador y API, la autenticación, las pruebas de autorización, los protocolos con estado, el diseño de playbooks, la validación independiente, el almacenamiento de evidencia, la resistencia a la inyección de prompts, el aislamiento de la ejecución, la gestión de recursos, las pruebas comparativas y una estrategia de implementación por fases.
También analiza las ventajas y desventajas de construir una plataforma desde cero frente a adaptar herramientas de seguridad existentes. El objetivo no es simplemente conectar escáneres a una interfaz de IA, sino construir un sistema cuya planificación sea adaptativa, cuya ejecución esté restringida, cuyos hallazgos sean reproducibles y cuyo desempeño pueda medirse contra una base de referencia conocida.
1. Introducción: de los escáneres de vulnerabilidades a los pentesters autónomos
1.1 Cómo funciona la automatización tradicional
La automatización tradicional de seguridad ejecuta una secuencia de operaciones predefinida.
Por ejemplo:
- Descubrir los endpoints web accesibles.
- Recorrer la aplicación mediante un crawler.
- Aplicar comprobaciones conocidas de vulnerabilidades.
- Comparar las respuestas con firmas o comportamientos esperados.
- Generar un reporte.
Este enfoque es valioso porque es repetible, relativamente predecible y más fácil de evaluar mediante pruebas comparativas. Sin embargo, los flujos predefinidos tienen dificultades para razonar sobre el comportamiento específico de una aplicación.
Un escáner puede descubrir un endpoint de facturas y probar sus parámetros, pero no entender que una factura pertenece a un usuario específico y que otro usuario no debería tener acceso a ella.
El problema no necesariamente es que falte un payload. Puede ser que falte una comprensión del modelo de autorización de la aplicación.
1.2 Pruebas asistidas por IA
Un escáner asistido por IA incorpora capacidades de modelos de lenguaje a un flujo de trabajo existente. Un LLM puede explicar una vulnerabilidad, clasificar una respuesta, generar una variación de prueba o recomendar la siguiente comprobación.
Sin embargo, el flujo de trabajo puede seguir siendo esencialmente estático.
Por ejemplo, el sistema puede ejecutar la misma colección de comprobaciones sin importar lo que descubra. La IA mejora tareas individuales sin controlar el proceso general de investigación.
1.3 Pruebas de penetración agénticas
Un sistema agéntico mantiene una representación de trabajo del objetivo, selecciona acciones según sus observaciones, evalúa los resultados y actualiza su plan.
Consideremos una prueba hipotética autorizada:
- El crawler descubre un endpoint de facturas de clientes.
- El planificador observa que la respuesta contiene un identificador de objeto.
- Formula la hipótesis de que el acceso podría depender de conocer el identificador, en lugar de verificar la propiedad del recurso.
- Consulta las identidades de prueba autorizadas y los permisos esperados definidos para la evaluación.
- Solicita el mismo recurso utilizando el contexto de una segunda cuenta de prueba.
- Un validador determinista compara el comportamiento observado con el modelo de permisos.
- Si se demuestra una divulgación no autorizada, el sistema registra la evidencia y deja de ampliar esa prueba fuera de los límites autorizados.
Si la segunda cuenta tiene derecho legítimo a acceder al recurso, la hipótesis debe rechazarse o modificarse. Si la sesión expira, el sistema debe registrar ese estado y recuperar o restablecer la sesión autorizada, en lugar de clasificar incorrectamente el resultado.
El comportamiento del agente cambia como consecuencia de la evidencia.
1.4 Una definición práctica de agencia real
Para este proyecto, un sistema debe considerarse agéntico cuando demuestra las siguientes capacidades:
| Capacidad | Comportamiento requerido |
|---|---|
| Observación | Recopila evidencia de la aplicación y de las herramientas |
| Representación del estado | Mantiene conocimiento de rutas, identidades, flujos de trabajo y pruebas anteriores |
| Planificación | Selecciona acciones con base en el estado actual |
| Uso de herramientas | Invoca herramientas aprobadas mediante interfaces definidas |
| Retroalimentación | Interpreta los resultados de ejecución y actualiza su estado |
| Adaptación | Cambia el plan cuando la evidencia invalida una hipótesis |
| Validación | Determina si una vulnerabilidad sospechosa cumple los criterios de evidencia |
| Detención | Reconoce cuándo se agotaron las opciones útiles, existe incertidumbre o se alcanzaron los límites de autorización |
Un LLM es un posible componente de este diseño, no un sustituto del sistema completo.
2. Definir el problema antes de elegir la tecnología
El producto inicial debe centrarse en evaluaciones externas de caja negra de aplicaciones web y API.
Supongamos que el sistema recibe:
- Un hostname, URL o inventario de activos autorizados.
- Ningún código fuente ni documentación privada de infraestructura por defecto.
- Credenciales de prueba opcionales que representan distintos roles o tenants.
- Especificaciones OpenAPI, sitemaps, archivos HAR u otra evidencia proporcionada, cuando estén disponibles.
- Un entorno controlado para navegadores, escáneres y módulos de prueba personalizados.
La plataforma no debe asumir que descubrir un hostname autoriza a probarlo, que una página de inicio de sesión implica que existen credenciales válidas o que una respuesta HTTP revela toda la arquitectura interna de la aplicación.
2.1 Distinguir la evidencia de las suposiciones
Un framework maduro debe mantener estados explícitos sobre el nivel de certeza.
| Estado | Significado |
|---|---|
| Observado | Está respaldado directamente por evidencia capturada |
| Inferido | Es una explicación plausible respaldada por evidencia incompleta |
| Sospechoso | Es una posible debilidad de seguridad que requiere validación |
| Validado | Se cumplieron los criterios de evidencia definidos |
| No reproducido | Un comportamiento observado anteriormente no pudo reproducirse bajo las condiciones documentadas |
| No concluyente | La evidencia disponible no permite establecer el resultado |
| No probado | La prueba correspondiente no se ejecutó |
| Bloqueado | La autorización, autenticación, controles defensivos o limitaciones técnicas impidieron la prueba |
| Fuera de alcance | El objetivo o la acción no están autorizados |
| Remediado | Las pruebas posteriores respaldan que el problema fue corregido |
La severidad de un hallazgo debe ser independiente de su nivel de confianza. Una posible vulnerabilidad crítica respaldada por evidencia débil no debe presentarse como una vulnerabilidad crítica confirmada.
Del mismo modo, la ausencia de vulnerabilidades detectadas no demuestra que una aplicación sea segura.
3. Arquitectura de referencia
La arquitectura propuesta separa el razonamiento, la autorización, la ejecución, la evidencia y la validación.
3.1 Diagrama lógico del sistema
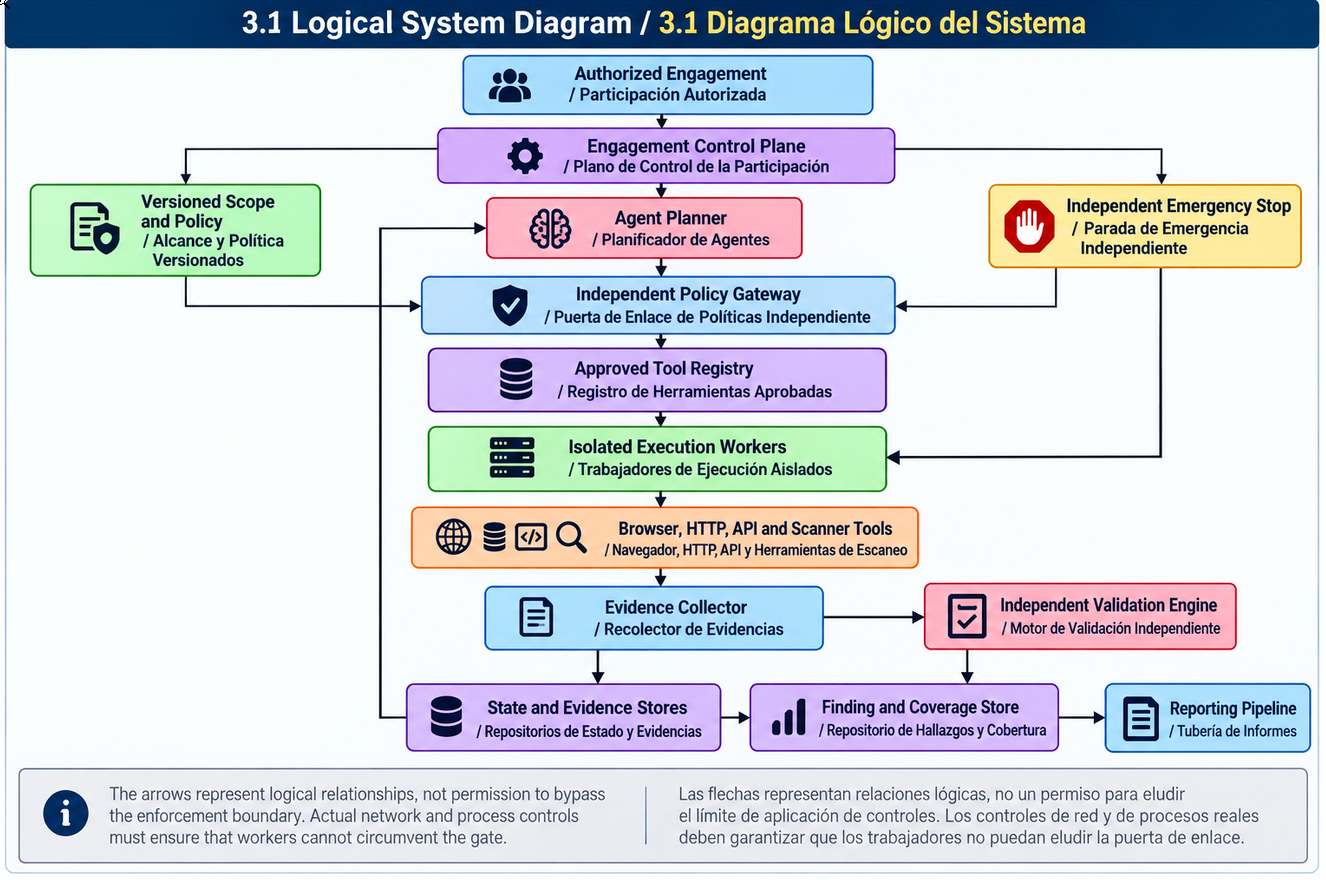
Las flechas representan relaciones lógicas, no permisos para omitir el límite de seguridad. Los controles de red y procesos deben garantizar que los workers no puedan eludir el gateway.
3.2 Componentes principales
| Componente | Responsabilidad principal |
|---|---|
| Plano de control de la evaluación | Autorización, alcance, presupuestos, programación y aprobaciones |
| Planificador agéntico | Generación de hipótesis, selección de acciones y adaptación |
| Gateway de políticas | Autoriza cada acción propuesta de forma independiente |
| Registro de herramientas | Expone herramientas aprobadas mediante interfaces tipadas |
| Workers de ejecución | Ejecutan pruebas autorizadas en entornos aislados |
| Almacén de estado | Registra el conocimiento de la aplicación y el avance de los flujos de trabajo |
| Recolector de evidencia | Captura y conserva observaciones con su procedencia |
| Motor de validación | Evalúa los hallazgos sospechosos con criterios definidos |
| Pipeline de reportes | Genera hallazgos respaldados por evidencia y registros de cobertura |
| Servicio de parada de emergencia | Detiene la ejecución independientemente del planificador |
El principio arquitectónico más importante es que el planificador propone acciones, pero no se concede a sí mismo permiso para ejecutarlas.
4. Plano de control de la evaluación y modelo de alcance
El alcance debe ser una política aplicada por la máquina, no simplemente texto incluido en un prompt.
4.1 Manifiesto de la evaluación
El manifiesto debe identificar:
- ID de la evaluación y su versión.
- Dominios, hostnames, direcciones IP, puertos y protocolos autorizados.
- Exclusiones explícitas y dependencias de terceros.
- Clases de pruebas permitidas y niveles de impacto.
- Ventanas de prueba y límites de velocidad.
- Límites máximos de solicitudes, concurrencia, tiempo de ejecución y costo.
- Identidades de prueba autorizadas y referencias a credenciales.
- Requisitos de aprobación humana.
- Políticas de conservación y manejo de evidencia.
- Comportamiento de parada de emergencia y recuperación.
Un manifiesto conceptual podría verse así:
engagement_id: engagement-2026-001
scope_version: 3

targets:
  - hostname: app.example.test
    protocols: [https]
    ports: [443]

excluded:
  - hostname: payments.example-provider.test

testing:
  mode: authorized_black_box
  permitted_classes:
    - passive_discovery
    - bounded_http_testing
    - authenticated_authorization_testing

limits:
  max_concurrent_requests: 4
  max_runtime_minutes: 60
  require_approval_for_state_changes: true
Este es un esquema ilustrativo, no una configuración universalmente segura. Los límites reales deben adaptarse a la aplicación, al acuerdo de autorización y al entorno.
4.2 Aplicar el alcance en el momento de ejecución
Cada acción debe verificarse, conceptualmente, en dos momentos:
- Cuando el planificador la propone.
- Inmediatamente antes de que el sistema de ejecución la realice.
La segunda verificación es esencial porque el alcance, la resolución DNS, el estado de la sesión y las políticas pueden cambiar entre la planificación y la ejecución.
La capa de aplicación de políticas debe evaluar la evaluación, el destino, el protocolo, el puerto, la operación, la clase de prueba, el presupuesto de recursos y los requisitos de aprobación.
Debe rechazar herramientas no registradas, parámetros inválidos, autorizaciones vencidas y destinos ambiguos.
4.3 DNS, redirecciones y límites de red
Un hostname puede resolver a diferentes direcciones a lo largo del tiempo. Un objetivo también puede redirigir al navegador hacia un proveedor de identidad, procesador de pagos, CDN o servicio de terceros sin relación con la aplicación.
El sistema no debe asumir que estos destinos heredan la autorización original.
Los controles necesarios incluyen:
- Validación de destinos IPv4 e IPv6 resueltos.
- Manejo de cadenas CNAME y cambios DNS.
- Verificación de cada destino de redirección antes de seguirlo.
- Restricción de protocolos y puertos.
- Prevención de conexiones directas no autorizadas desde los workers.
- Manejo de riesgos de DNS rebinding y de condiciones de carrera entre verificación y uso.
- Restricciones para proxies, navegadores y conexiones específicas de cada herramienta.
Un proxy no es suficiente si un worker puede abrir su propio socket sin restricciones. Cuando sea viable, el tráfico debe pasar por políticas de red, reglas de firewall, un proxy con listas de permitidos u otro mecanismo independiente equivalente.
Las pruebas negativas deben intentar redirecciones fuera de alcance, conexiones no autorizadas, puertos alternativos y salida directa a la red. El resultado esperado es que la capa de aplicación de políticas las rechace.
5. El planificador agéntico: razonar sin autoridad ilimitada
5.1 Mantener un estado explícito
El planificador necesita una representación estructurada de lo que conoce.
Como mínimo, debe mantener:
- Activos y endpoints descubiertos.
- Contextos de autenticación y autorización.
- Estados y transiciones de la aplicación.
- Parámetros observados y características de las respuestas.
- Hipótesis existentes y evidencia que las respalda.
- Pruebas ejecutadas y sus resultados.
- Brechas de cobertura y requisitos bloqueados.
- Presupuestos restantes y restricciones de las políticas aplicables.
Sin estado persistente, el agente puede repetir pruebas, perder el contexto de autenticación o tratar incorrectamente un endpoint previamente evaluado como si no se hubiera explorado.
5.2 La planificación como ciclo de retroalimentación
Un ciclo de planificación útil es:
- Leer el estado actual de la evaluación.
- Identificar una pregunta de seguridad sin resolver.
- Generar una o varias hipótesis de prueba.
- Estimar prerrequisitos, valor de la información, costo e impacto.
- Seleccionar una acción del registro de capacidades aprobadas.
- Enviar la acción al gateway de políticas.
- Ejecutarla únicamente si está autorizada.
- Capturar evidencia y actualizar el estado.
- Validar o ajustar la hipótesis.
- Continuar, solicitar aprobación o detenerse.
Este ciclo debe estar limitado por los controles de ejecución y las condiciones explícitas de detención.
5.3 ¿Cómo debe seleccionar las pruebas el planificador?
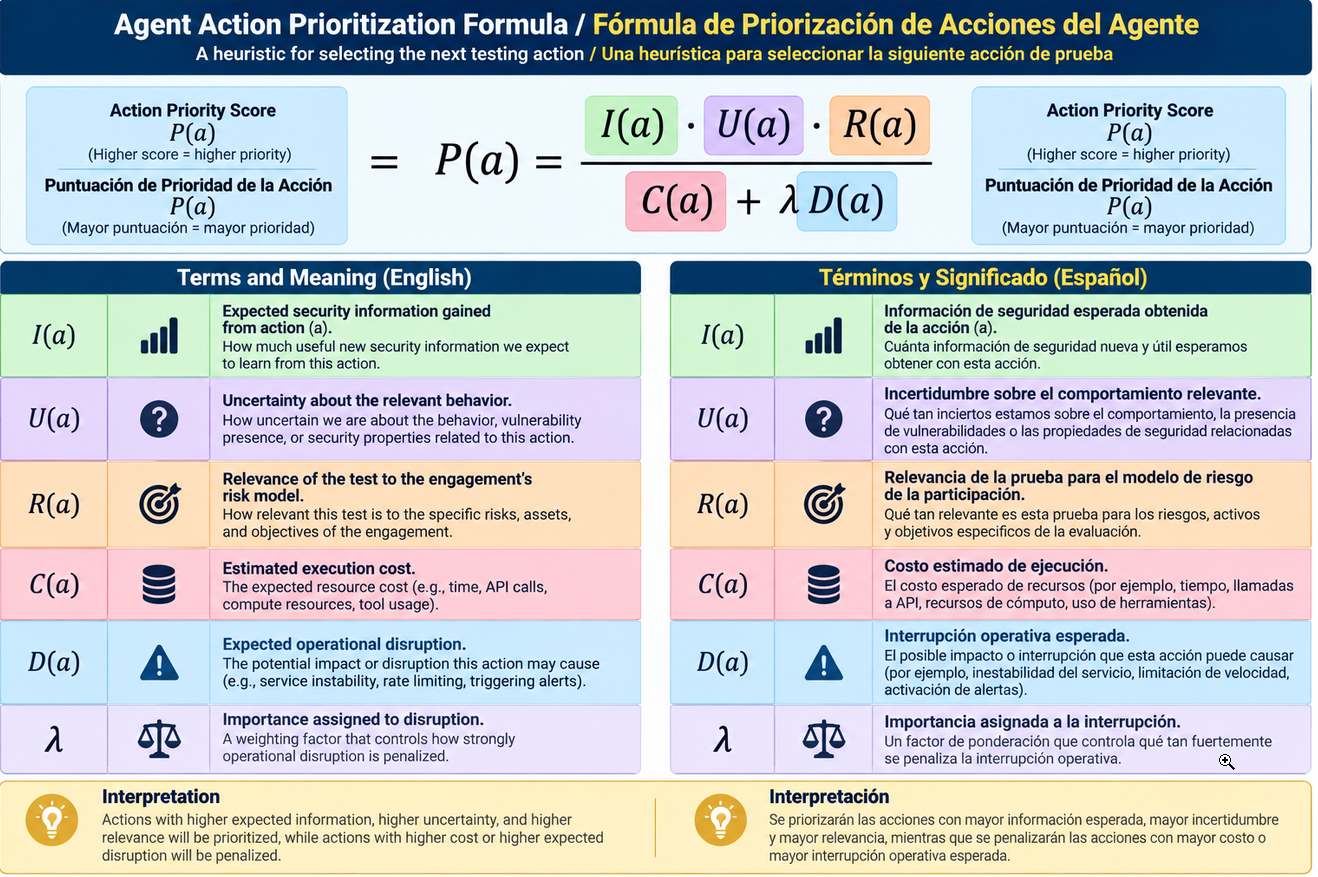
Una puntuación conceptual de priorización podría ser:
Esta es una heurística conceptual, no una fórmula universal validada. Nunca debe prevalecer sobre las reglas estrictas de autorización ni sobre los límites de recursos.
Por ejemplo, si dos endpoints implementan funcionalidades similares, pero uno expone un tipo de objeto más sensible, el planificador puede priorizar el endpoint de mayor riesgo. Sin embargo, debe cumplir los prerrequisitos de la prueba y las restricciones de impacto.
5.4 ¿Un agente o varios?
Tener varios agentes no significa automáticamente obtener mejores resultados.
Un único orquestador con módulos especializados suele ser más fácil de depurar, evaluar y proteger. Una arquitectura multiagente puede justificarse cuando las tareas requieren modelos distintos, investigación independiente o ejecución paralela.
Comienza con un único planificador y módulos deterministas. Agrega agentes especializados solamente cuando proporcionen beneficios medibles.
El gateway de políticas debe seguir siendo un servicio aplicado de forma independiente, sin importar cuántos agentes existan.
6. Reconocimiento dinámico y mapeo de la superficie de ataque
Una aplicación web no es simplemente una colección de URLs. Es un conjunto de estados alcanzables, acciones, identidades, objetos y transiciones.
6.1 Descubrimiento de activos externos
Un pipeline de descubrimiento puede combinar:
- DNS pasivo y datos de transparencia de certificados.
- Descubrimiento autorizado de subdominios y DNS.
- Verificación de endpoints HTTP y HTTPS.
- Observaciones sobre TLS y configuración de servicios.
- Descubrimiento de API públicas y sus versiones.
- Documentación y artefactos de configuración accesibles públicamente.
- Inventarios de activos y especificaciones de API proporcionados por el cliente.
Los activos candidatos deben validarse contra el manifiesto de la evaluación antes de realizar pruebas activas.
El motor de descubrimiento debe registrar la procedencia. Por ejemplo, un activo puede haberse observado en un certificado, haber sido proporcionado por el cliente, haberse descubierto mediante un enlace o haberse inferido desde JavaScript.
Estas fuentes no ofrecen el mismo nivel de confianza respecto a si el activo pertenece a la aplicación que se pretende evaluar.
6.2 Descubrimiento mediante navegador
Las aplicaciones modernas suelen ocultar funcionalidades importantes detrás del enrutamiento del lado del cliente y de solicitudes asíncronas.
Una herramienta de automatización de navegador como Playwright puede observar tráfico HTTP, solicitudes Fetch/XHR, redirecciones y actividad WebSocket. Sus API de red también permiten interceptar solicitudes y manejar respuestas de forma controlada. Consulta la documentación de red de Playwright.
Un adaptador de descubrimiento basado en navegador debe capturar:
- Transiciones de rutas del lado del cliente.
- Formularios y envíos de formularios.
- Solicitudes Fetch y XHR.
- Rutas de API, métodos, parámetros y tipos de contenido.
- Cambios de autenticación.
- Capturas relevantes del DOM.
- Metadatos de conexiones y mensajes WebSocket.
- Errores y transiciones fallidas.
- Enlaces y recursos descubiertos en JavaScript.
No debe tratarse el descubrimiento de una ruta como prueba de que ya fue evaluada completamente.
6.3 Modelar la aplicación como un grafo
Representa la aplicación mediante un grafo:
- Nodos: rutas, endpoints de API, identidades, objetos, sesiones y estados del flujo de trabajo.
- Aristas: solicitudes, redirecciones, envíos de formularios, transiciones de autenticación y acciones de negocio.
- Atributos: permisos, prerrequisitos, evidencia y confianza.
Por ejemplo, un flujo de administración de pedidos podría contener:
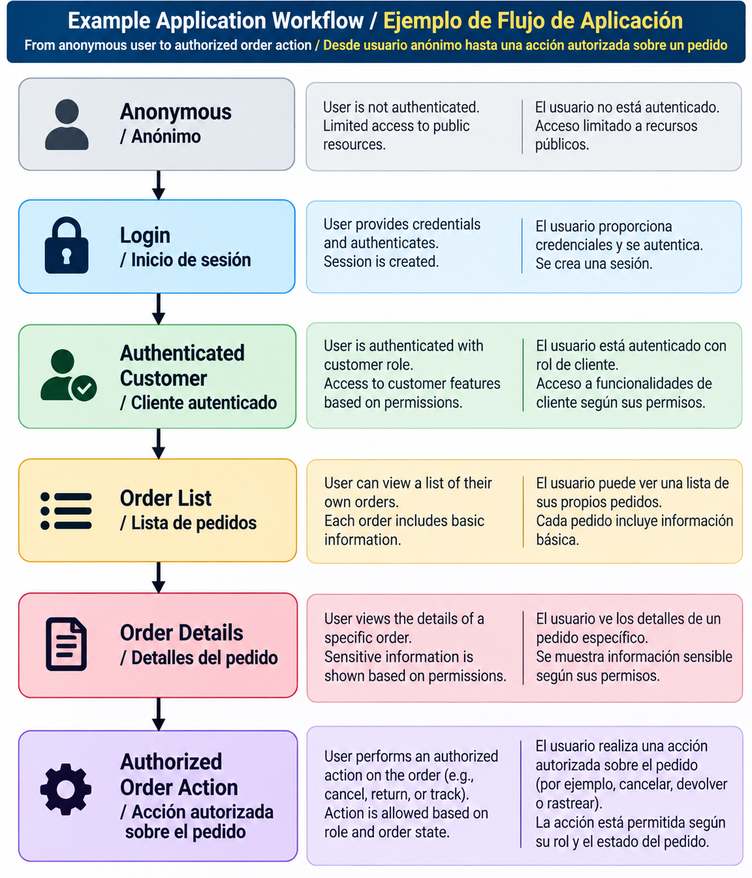
Cada transición tiene prerrequisitos y un resultado esperado. Probar el endpoint de detalles sin el estado autenticado correspondiente puede proporcionar muy poca información útil.
6.4 La cobertura debe describir más que el descubrimiento
Registra hitos separados:
- Descubierto.
- Dentro del alcance.
- Accesible.
- Autenticado.
- Ejercitado.
- Evaluado desde el punto de vista de seguridad.
- Validado.
- Bloqueado o no concluyente.
Una ruta puede haberse descubierto, pero nunca haberse alcanzado. Puede haberse alcanzado de forma anónima, pero no como administrador. Puede haberse evaluado para inyección, pero no para autorización.
Un reporte de cobertura debe preservar estas diferencias.
6.5 Inferencia de arquitectura
El sistema puede inferir aspectos de la arquitectura externa a partir del comportamiento HTTP, DNS, TLS, JavaScript, tráfico de API y documentos proporcionados.
Sin embargo, no debe afirmar que conoce las bases de datos internas, las políticas privadas de IAM, la topología interna de red o la configuración de la nube sin evidencia.
El modelo de arquitectura debe separar los hechos observados de las hipótesis.
7. Pruebas de autenticación, sesiones y autorización
La autenticación y la autorización son problemas de seguridad distintos.
La autenticación establece quién o qué interactúa con la aplicación. La autorización determina a qué objetos, propiedades y acciones puede acceder esa identidad.
Un framework de pruebas útil debe modelar ambas.
7.1 Matriz de identidades y permisos
Representa las identidades de prueba autorizadas y los permisos que se espera que tengan.
| Contexto de identidad | Recurso propiedad de la identidad | Recurso de otro usuario de prueba | Operación administrativa |
|---|---|---|---|
| Anónimo | Normalmente restringido, según el diseño | Normalmente restringido, según el diseño | Normalmente restringida |
| Cliente A | Aplicar la política esperada | Aplicar la política esperada | Aplicar la política esperada |
| Cliente B | Aplicar la política esperada | Aplicar la política esperada | Aplicar la política esperada |
| Administrador | Aplicar la política administrativa documentada | Aplicar la política administrativa documentada | Solo si está autorizado |
Estos son ejemplos, no reglas universales. Algunos recursos son públicos, algunos roles comparten acceso y ciertas aplicaciones implementan permisos delegados.
El framework debe establecer el comportamiento esperado antes de declarar un fallo.
7.2 Ciclo de vida de la sesión
El sistema debe comprender:
- Inicio y cierre de sesión.
- Rotación de cookies.
- Expiración e invalidación de sesiones.
- Tokens CSRF.
- Refresh tokens.
- MFA y autenticación reforzada.
- Proveedores de identidad externos.
- Flujos de reautenticación.
- Sesiones concurrentes.
- Diferencias entre sesiones de navegador y tokens de API.
Si una sesión expira, la prueba debe entrar en un estado de fallo conocido y recuperarse únicamente mediante un procedimiento autorizado. Una redirección a la página de inicio de sesión no demuestra una vulnerabilidad.
7.3 BOLA, IDOR, BOPLA y BFLA
Las pruebas de autorización son uno de los requisitos más importantes para un pentester agéntico de aplicaciones web y API.
OWASP API Security Top 10:2023 identifica Broken Object Level Authorization, Broken Object Property Level Authorization y Broken Function Level Authorization como riesgos diferentes. Consulta la guía de OWASP API Security Top 10.
- BOLA/IDOR: Un usuario puede acceder a un objeto al que no debería tener permiso de acceso.
- BOPLA: Un usuario puede leer o modificar propiedades de un objeto fuera de sus permisos.
- BFLA: Un usuario puede invocar funciones reservadas para otro rol o nivel de privilegio.
- Fallo de aislamiento entre tenants: Un tenant puede acceder a recursos protegidos de otro tenant.
Un proceso de validación sólido debe:
- Identificar el objeto y su propietario autorizado o política de acceso.
- Establecer el modelo de permisos esperado.
- Ejecutar una solicitud de referencia bajo un contexto autorizado.
- Comparar el comportamiento bajo otra identidad o rol de prueba permitido.
- Evaluar si la respuesta expone datos protegidos o realiza una acción no autorizada.
- Revisar explicaciones alternativas, como acceso compartido, recursos públicos y comportamiento de caché.
- Conservar la evidencia necesaria para reproducir el problema.
Cambiar un identificador y observar una respuesta diferente no constituye, por sí solo, una vulnerabilidad demostrada.
8. Protocolos con estado y flujos de negocio
Algunos fallos de seguridad solo se hacen visibles después de una secuencia de interacciones válidas con la aplicación.
Algunos ejemplos son:
- Un mensaje WebSocket enviado después de un handshake autenticado.
- Una transacción que pasa por varias etapas de aprobación.
- Un flujo en el que se emite un token temporal en un paso y se utiliza en otro.
- Un trabajo asíncrono que termina después de la solicitud HTTP inicial.
- Una mutación GraphQL cuyo efecto depende del estado previamente establecido en la aplicación.
Un framework que trate cada solicitud de forma independiente pasará por alto algunos de estos comportamientos.
8.1 Adaptadores de protocolo
Utiliza adaptadores específicos para WebSockets, Server-Sent Events, GraphQL y otras interfaces con estado.
Cada adaptador debe registrar:
- Estado de conexión y handshake.
- Contexto de autenticación.
- Secuencia de mensajes.
- Identificadores de correlación.
- Prerrequisitos relevantes del flujo de trabajo.
- Respuestas parciales y tiempos de espera.
- Expiración de sesión.
- Comportamiento de reintentos y reconexión.
- Cancelación y limpieza.
8.2 Flujos asíncronos
Una solicitud exitosa puede devolver un identificador de trabajo antes de que la operación real termine.
El framework debe distinguir entre la aceptación de la solicitud y la finalización de la operación. Debe utilizar consultas periódicas con límites o callbacks autorizados, conservar los identificadores de correlación y considerar la consistencia eventual.
Los reintentos requieren especial cuidado: repetir una solicitud puede crear pedidos duplicados, enviar mensajes o activar otros efectos secundarios.
8.3 Pruebas de lógica de negocio
Las fallas de lógica de negocio suelen requerir un modelo del comportamiento previsto, no un payload genérico.
Algunos ejemplos son:
- Ejecutar una transición del flujo de trabajo sin cumplir el prerrequisito necesario.
- Reutilizar una operación que debería ser de un solo uso.
- Acceder a un objeto después de que cambien los permisos.
- Violar una relación esperada entre la propiedad de un recurso y una acción.
- Repetir una acción sensible más veces de las permitidas.
El framework debe codificar las expectativas de negocio como invariantes comprobables. Las operaciones destructivas y las transacciones financieras deben excluirse salvo autorización explícita, y conviene probarlas con datos sintéticos o en entornos de prueba dedicados siempre que sea posible.
9. Cobertura de vulnerabilidades: OWASP para aplicaciones web y API
Un framework útil debe utilizar taxonomías de seguridad versionadas, en lugar de mantener una lista desestructurada de pruebas.
9.1 OWASP Top 10:2025
El OWASP Top 10:2025 contiene las siguientes categorías:
| Categoría | Qué puede investigar el framework |
|---|---|
| A01 Broken Access Control | Acceso no autorizado a objetos, funciones y recursos protegidos |
| A02 Security Misconfiguration | Encabezados inseguros observables, servicios expuestos y debilidades de configuración |
| A03 Software Supply Chain Failures | Indicadores públicos de dependencias y cadena de suministro, sujetos a las limitaciones de evidencia |
| A04 Cryptographic Failures | Problemas observables de TLS, transporte e implementación criptográfica |
| A05 Injection | Debilidades en el manejo de entradas y evidencia específica de cada clase |
| A06 Insecure Design | Violaciones comprobables de reglas de negocio e invariantes de seguridad |
| A07 Authentication Failures | Debilidades observables de autenticación, sesiones e identidad |
| A08 Software or Data Integrity Failures | Fallas relevantes de integridad y límites de confianza |
| A09 Security Logging and Alerting Failures | Observaciones limitadas desde caja negra; el registro interno generalmente requiere acceso o telemetría adicional |
| A10 Mishandling of Exceptional Conditions | Comportamiento inseguro ante fallos, exposición de información y debilidades relevantes en el manejo de errores |
La taxonomía es un marco de clasificación, no una garantía de que todas las categorías puedan evaluarse de manera concluyente desde la interfaz pública.
Por ejemplo, una prueba externa de caja negra generalmente no puede determinar si se generaron alertas de seguridad internas, salvo que la evaluación permita observar el sistema de registro o monitoreo.
9.2 OWASP API Security Top 10:2023
La taxonomía específica para API aporta un enfoque adicional:
| Categoría | Enfoque de prueba |
|---|---|
| API1 BOLA | Autorización a nivel de objeto |
| API2 Broken Authentication | Validación de identidad y tokens |
| API3 BOPLA | Permisos de lectura y escritura a nivel de propiedad |
| API4 Unrestricted Resource Consumption | Pruebas acotadas de consumo de recursos |
| API5 BFLA | Autorización de funciones y roles |
| API6 Unrestricted Access to Sensitive Business Flows | Abuso de flujos de negocio sensibles |
| API7 SSRF | Comportamiento de solicitudes originadas en el servidor, mediante validación segura y autorizada |
| API8 Security Misconfiguration | Exposición y configuración de API |
| API9 Improper Inventory Management | Versiones de API, endpoints obsoletos e interfaces no documentadas |
| API10 Unsafe Consumption of APIs | Límites de confianza al procesar datos de API de terceros o sistemas posteriores |
El proyecto OWASP API Security ofrece la guía pertinente.
9.3 Mantener una clasificación de evaluabilidad
Para cada categoría, documenta si es:
- Comprobable externamente.
- Comprobable bajo ciertas condiciones.
- Dependiente de acceso o telemetría adicional.
- No evaluable dentro de la evaluación actual.
Esto evita confundir la existencia de un playbook con una cobertura de seguridad completa.
La OWASP Web Security Testing Guide es otra referencia importante para construir el catálogo de pruebas. Su metodología cubre recopilación de información, identidad, autenticación, autorización, gestión de sesiones, validación de entradas, lógica de negocio, pruebas del lado del cliente y generación de reportes. La versión estable es la 4.2, mientras que el proyecto está desarrollando la versión 5.0. Consulta el proyecto oficial WSTG.
10. Registro de herramientas y adaptadores de ejecución
No hagas responsable al LLM de inventar comandos de herramientas y ejecutarlos directamente.
En su lugar, expón un registro de capacidades aprobadas con entradas tipadas, permisos explícitos, salidas acotadas y limitaciones conocidas.
10.1 Una cadena inicial de herramientas práctica
| Capacidad | Candidato | Motivo para utilizarlo |
|---|---|---|
| Automatización de navegador | Playwright | Descubrimiento de aplicaciones interactivas y observación del tráfico |
| Cliente HTTP | Python httpx | Solicitudes HTTP controladas y manejo estructurado de respuestas |
| Pruebas dinámicas | OWASP ZAP | Capacidades existentes para evaluar aplicaciones web |
| Comprobaciones por plantillas | Nuclei con plantillas revisadas | Detección reutilizable y acotada |
| Descubrimiento DNS | Utilidades DNS y herramientas de descubrimiento autorizadas | Identificación de activos dentro del alcance |
| Descubrimiento de servicios | Nmap, cuando esté expresamente autorizado | Evaluación controlada de servicios y puertos |
| Evaluación TLS | testssl.sh o equivalente | Comprobaciones de configuración de transporte |
| Validación personalizada | Módulos Python | Evaluación de evidencia específica de la aplicación |
| Inventario de API | Parsers OpenAPI e inventarios derivados del tráfico | Seguimiento de endpoints y esquemas |
Estas son herramientas candidatas, no una recomendación de instalar todas desde el inicio. Selecciona las herramientas según el alcance, el entorno operativo, las licencias, el mantenimiento y la calidad de la evidencia.
10.2 Interfaz del adaptador
Cada adaptador debe definir:
- Esquema de entrada.
- Esquema de salida.
- Operaciones permitidas.
- Restricciones de destino y protocolo.
- Clasificación de impacto.
- Límites de recursos.
- Comportamiento de timeout y cancelación.
- Estados de error.
- Formato de evidencia.
- Versión y configuración de la herramienta.
- Limitaciones conocidas.
Una interfaz ilustrativa:
class TestAdapter:
    def validate_input(self, request, engagement):
        """Validar el esquema y los prerrequisitos."""

    def classify_impact(self, request):
        """Devolver la clasificación de impacto registrada."""

    def execute(self, request, execution_context):
        """Ejecutar una operación autorizada y acotada."""

    def normalize_result(self, raw_result):
        """Devolver resultados estructurados y referencias de evidencia."""
Esta es una interfaz conceptual; la implementación debe garantizar que el adaptador no pueda eludir el gateway externo de políticas.
10.3 Generación controlada de scripts
El código generado puede ayudar a crear comprobaciones específicas de una aplicación, pero introduce riesgos importantes.
Un script generado podría incluir un destino de red no previsto, filtrar credenciales, consumir recursos excesivos o realizar una acción destructiva.
Utiliza este orden de preferencia:
- Reutilizar un playbook aprobado.
- Invocar una herramienta existente mediante un adaptador controlado.
- Ampliar un módulo de prueba reutilizable y revisado.
- Generar un script acotado únicamente cuando las capacidades existentes sean insuficientes.
Los scripts generados deben pasar por validación de esquemas, análisis estático, restricciones de dependencias, revisión proporcional al riesgo y ejecución aislada.
No deben recibir acceso irrestricto a la shell, a la red, a la instalación de paquetes ni al sistema de archivos.
11. Ingeniería de playbooks
Un playbook debe describir un método de prueba completo, no solamente un payload.
Cada playbook debe especificar:
| Campo | Propósito |
|---|---|
| ID y versión | Identidad estable y reproducibilidad |
| Hipótesis | Comportamiento de seguridad que se investiga |
| Prerrequisitos | Endpoint, estado y evidencia necesarios |
| Contexto de identidad | Rol o tenant requerido |
| Esquema de entrada | Parámetros aprobados |
| Nivel de impacto | Efecto operativo permitido |
| Adaptador de herramienta | Mecanismo de ejecución |
| Línea base | Comportamiento esperado para comparar |
| Requisitos de evidencia | Qué respaldaría la conclusión |
| Criterios de validación | Condiciones para confirmar el hallazgo |
| Condiciones de falso positivo | Explicaciones alternativas |
| Límites | Solicitudes, tiempo, concurrencia y recursos |
| Condiciones de detención | Cuándo terminar la prueba |
| Limpieza | Recuperación o restauración necesaria |
| Referencias | Clasificación CWE, mapeo OWASP y metodología |
11.1 Por qué es importante
Supongamos que una aplicación devuelve una respuesta diferente cuando cambia un identificador. Esa observación podría indicar un problema de autorización, pero también podría reflejar un objeto inexistente, el comportamiento de una caché o un recurso público previsto.
Un playbook bien diseñado define la línea base y el modelo de autorización esperado antes de ejecutar la prueba. Después, el sistema de validación determina si la diferencia observada cumple los criterios de un hallazgo.
Esto es más confiable que pedirle a un LLM que decida si una respuesta “parece vulnerable”.
12. Validación independiente y calidad de la evidencia
El planificador no debe ser el único responsable de juzgar sus propias hipótesis.
Una segunda llamada a un LLM no proporciona automáticamente una verificación independiente. Ambas llamadas pueden compartir las mismas suposiciones equivocadas.
12.1 Un motor de validación separado
El subsistema de validación debe utilizar comprobaciones deterministas revisadas siempre que sea práctico.
Algunos ejemplos:
- Hallazgos de autorización evaluados contra un modelo de permisos esperado.
- Hallazgos de inyección evaluados mediante evidencia específica de la clase de vulnerabilidad y comparaciones de referencia apropiadas.
- Hallazgos de SSRF evaluados mediante evidencia autorizada y correlacionada, en lugar de una diferencia genérica en la respuesta.
- Hallazgos de dependencias que distingan una huella de versión de la evidencia de que el código vulnerable está presente y es relevante.
- Hallazgos de encabezados de seguridad que distingan la ausencia de un encabezado de un impacto demostrado.
- Hallazgos de manejo de errores que distingan un fallo esperado de una debilidad de seguridad.
La lógica de validación variará según la clase de vulnerabilidad. No todas las clases pueden validarse completamente mediante un predicado determinista sencillo, y algunos hallazgos requerirán revisión experta.
12.2 Esquema de evidencia
Un hallazgo debe contener suficiente información para que otro ingeniero pueda reproducirlo y evaluarlo.
Una estructura JSON ilustrativa:
{
  "finding_id": "F-00042",
  "engagement_id": "engagement-2026-001",
  "title": "Posible acceso a objetos de otros usuarios",
  "status": "suspected",
  "severity": "unassigned",
  "confidence": "low",
  "asset": "app.example.test",
  "endpoint_ref": "endpoint-018",
  "identity_context": {
    "actor_ref": "test-user-b",
    "expected_policy_ref": "policy-007"
  },
  "evidence_refs": [
    "evidence-102",
    "evidence-103"
  ],
  "validation": {
    "validator_version": "authz-validator-1.0",
    "result": "pending"
  },
  "limitations": [
    "Debe confirmarse la política esperada para compartir objetos"
  ]
}
El ejemplo deja intencionalmente el hallazgo sin validar. Un esquema no debe convertir una hipótesis en una vulnerabilidad confirmada simplemente porque se generó un reporte.
12.3 Procedencia de la evidencia
Registra:
- Referencias a solicitudes y respuestas.
- Encabezados y códigos de estado relevantes.
- Cuerpos redactados o fragmentos acotados.
- Referencias a identidades y sesiones.
- Estado de la aplicación antes y después de la ejecución.
- Versiones de herramientas y playbooks.
- Marcas de tiempo e identificadores de ejecución.
- Decisión de política y resultado de validación.
Los artefactos sin procesar que contengan información sensible deben almacenarse por separado del contexto del modelo. El modelo solo debe recibir los fragmentos relevantes o resúmenes estructurados mínimos necesarios para la tarea.
12.4 Severidad y confianza
La severidad describe el impacto potencial y la explotabilidad. La confianza describe qué tan sólidamente respalda la evidencia disponible el hallazgo.
Son dimensiones diferentes. Una posible debilidad de alto impacto puede requerir investigación humana urgente sin que deba reportarse como una vulnerabilidad crítica confirmada.
13. Inyección de prompts y seguridad del propio agente
Un pentester agéntico introduce una segunda superficie de ataque: la propia plataforma de pruebas.
El contenido controlado por el objetivo puede incluir instrucciones maliciosas en HTML, JavaScript, respuestas de API, mensajes de error, archivos o documentación.
Un modelo podría interpretar ese contenido como instrucciones para ampliar el alcance, revelar credenciales o invocar herramientas.
13.1 Tratar el contenido del objetivo como no confiable
La arquitectura debe:
- Preservar la procedencia de todas las observaciones.
- Distinguir las políticas confiables de los datos no confiables del objetivo.
- Utilizar esquemas estructurados de entrada y salida.
- Mantener los secretos fuera del contexto del modelo, salvo que sean estrictamente necesarios.
- Rechazar las llamadas a herramientas no autorizadas fuera del modelo.
- Restringir el código generado.
- Validar la evidencia antes de utilizarla para decisiones importantes.
- Mantener la aplicación de políticas independiente de la salida del planificador.
Los delimitadores y las instrucciones del prompt pueden ayudar al modelo a interpretar correctamente los datos, pero no son controles de seguridad suficientes.
13.2 Probar adversarialmente la plataforma
Crea casos de prueba en los que el contenido del objetivo intente:
- Ampliar el alcance autorizado.
- Solicitar credenciales o secretos.
- Activar una herramienta no registrada.
- Provocar ejecución arbitraria de código.
- Suprimir o alterar un hallazgo.
- Agotar los presupuestos de contexto o ejecución.
- Engañar al agente mediante instrucciones falsas o evidencia fabricada.
El resultado requerido no es simplemente que el modelo reconozca el ataque. La capa de aplicación de políticas debe impedir las acciones prohibidas incluso si el modelo las propone.
Para obtener principios más amplios de gestión de riesgos de IA, el perfil de IA generativa del NIST ofrece un marco útil para identificar y gestionar riesgos asociados con sistemas de IA generativa.
14. Aislamiento de ejecución, credenciales y parada de emergencia
14.1 Workers aislados
Los navegadores, escáneres y módulos personalizados deben ejecutarse en entornos dedicados y con privilegios mínimos.
Los controles deben abarcar:
- Salida de red.
- Acceso al sistema de archivos.
- Ejecución de procesos.
- CPU, memoria y tiempo de ejecución.
- Tamaño de salida.
- Credenciales.
- Instalación de dependencias.
- Comunicación entre workers.
- Conservación de evidencia.
Los contenedores son un mecanismo útil de aislamiento, pero la contenerización por sí sola no constituye una frontera de seguridad completa. También deben considerarse las políticas de red, la configuración del runtime, la seguridad del host y los permisos.
14.2 Ciclo de vida de los secretos
Utiliza un gestor de secretos y credenciales de corta duración cuando sea práctico.
Guarda referencias a las credenciales en lugar de sus valores sin procesar dentro del estado del flujo de trabajo. Redacta tokens, cookies, contraseñas e identificadores de sesión antes de generar registros generales o construir el contexto del modelo.
Define la rotación, revocación, auditoría de acceso y eliminación de credenciales.
Realiza pruebas para detectar filtraciones de secretos a través de trazas, errores, capturas de pantalla, artefactos del navegador, código generado y reportes finales.
14.3 Aislamiento entre evaluaciones
Asigna a cada evaluación un identificador inmutable y aplica aislamiento en:
- Consultas a bases de datos.
- Almacenamiento de objetos.
- Cachés.
- Colas.
- Recuperación vectorial.
- Credenciales.
- Entornos de ejecución.
- Registros y reportes.
El aislamiento debe aplicarse en las capas de acceso a datos y ejecución, no simplemente pidiéndole al modelo que recuerde qué cliente está evaluando.
14.4 Parada de emergencia independiente
El servicio de parada de emergencia debe funcionar incluso si el planificador entra en un ciclo infinito o se ve comprometido.
Debe ser capaz de:
- Revocar la salida de red específica de la evaluación.
- Impedir que comiencen nuevos trabajos.
- Cancelar tareas en cola.
- Terminar workers activos.
- Cerrar o invalidar sesiones cuando sea práctico.
- Registrar los identificadores de ejecución afectados y el motivo de la parada.
- Exigir autorización explícita antes de reanudar.
Es posible que algunas solicitudes ya enviadas u operaciones asíncronas no puedan cancelarse. El sistema debe documentar esta limitación y proporcionar procedimientos de recuperación.
15. Presupuestos de recursos y manejo de fallos
Los sistemas autónomos pueden desperdiciar recursos debido a pruebas repetidas, reintentos improductivos, ciclos de planificación o llamadas excesivas al modelo.
Define presupuestos en los niveles de evaluación, worker, herramienta, endpoint y playbook.
Los límites pertinentes incluyen:
- Cantidad de solicitudes y conexiones.
- Concurrencia.
- Tiempo de ejecución.
- Límites de reintentos.
- Recursos del navegador y de los scripts.
- Costo de llamadas al modelo y de ejecución.
- Umbrales de errores y tiempos de espera.
- Respuestas de limitación de velocidad.
- Tamaño de salidas y artefactos de evidencia.
Utiliza configuraciones conservadoras en la primera versión y mide su efecto en entornos controlados.
15.1 Estados terminales explícitos
Cada ejecución debe terminar en un estado definido, por ejemplo:
- Completada.
- Hallazgo validado.
- No se observó un problema bajo las condiciones probadas.
- No concluyente.
- Bloqueada.
- Cancelada.
- Fallida.
- Fuera de alcance.
El fallo de una herramienta nunca debe interpretarse como prueba de que una vulnerabilidad está ausente.
15.2 Diseño de recuperación
Define el comportamiento para:
- Sesiones expiradas.
- Barreras de MFA y CAPTCHA.
- Caídas del navegador.
- Cambios DNS.
- Bloqueos de WAF y límites de velocidad.
- Desconexiones de WebSocket.
- Salidas parciales de herramientas.
- Tiempos de espera del LLM.
- Agotamiento del contexto.
- Caídas de workers.
- Conflictos de estado concurrente.
- Fallos de base de datos.
- Cancelación de emergencia.
Los reintentos deben tener límites y las operaciones que modifican el estado no deben repetirse a ciegas.
16. Arquitectura de datos y persistencia
Una base de datos relacional suele ser suficiente para la primera versión.
Utilízala para almacenar evaluaciones, activos, endpoints, identidades, sesiones, pruebas, hallazgos, presupuestos, decisiones de política y estados de ejecución.
Almacena los artefactos grandes en almacenamiento de objetos. Utiliza registros de evidencia inmutables o a prueba de alteraciones cuando corresponda.
16.1 ¿Necesitas una base de datos de grafos?
No inicialmente.
Un esquema relacional puede representar endpoints, transiciones de estado y relaciones. Incorpora una base de datos de grafos dedicada cuando las consultas relacionales se vuelvan difíciles de mantener o afecten de manera importante el rendimiento de la planificación.
16.2 ¿Necesitas una base de datos vectorial?
No necesariamente.
La primera versión puede recuperar playbooks y documentación aprobados mediante metadatos indexados, búsqueda de texto o consultas convencionales a la base de datos. Un almacén vectorial resulta útil cuando la recuperación semántica sobre una biblioteca amplia y curada demuestra beneficios medibles.
Los resultados de recuperación deben conservar la fuente, la versión y la procedencia. La similitud semántica no demuestra que un playbook sea aplicable a un objetivo específico.
16.3 Entidades de datos iniciales recomendadas
| Entidad | Campos principales |
|---|---|
| Evaluación | ID, versión del alcance, autorización, límites y estado |
| Activo | ID, hostname, protocolo, estado de alcance y procedencia |
| Endpoint | ID, activo, método, ruta, parámetros y estado de descubrimiento |
| Identidad | ID, rol, tenant y referencia a credenciales |
| Estado de aplicación | ID, contexto de identidad, posición del flujo y referencias de evidencia |
| Ejecución de prueba | ID, versión del playbook, decisión de política, tiempos y resultado |
| Hipótesis | ID, comportamiento investigado, evidencia, confianza y estado |
| Hallazgo | ID, severidad, confianza, estado y remediación |
| Artefacto de evidencia | ID, ubicación, hash, estado de redacción y procedencia |
| Decisión de política | ID, acción, objetivo, decisión, motivo y versión de política |
Utiliza migraciones y esquemas versionados para que las evaluaciones antiguas sigan siendo interpretables después de que evolucione el software.
17. Reportes y auditabilidad
Un reporte debe explicar no solo qué encontró el sistema, sino también qué probó y qué no pudo probar.
Un reporte completo debe contener:
- Resumen ejecutivo.
- Alcance y exclusiones.
- Metodología y versiones de herramientas.
- Inventario de activos y endpoints.
- Cobertura por ruta, identidad, flujo de trabajo y categoría de vulnerabilidad.
- Hallazgos validados con evidencia y severidad.
- Metodología de reproducción.
- Impacto técnico y de negocio.
- Recomendaciones de remediación.
- Áreas no probadas, bloqueadas o no concluyentes.
- Límites de recursos y fallos de ejecución relevantes.
- Procedencia de la evidencia y marcas de tiempo.
Conserva un registro de auditoría de cada decisión: hipótesis, evidencia que la respalda, acción propuesta, decisión de política, resultado de ejecución, resultado de validación y motivo de detención.
No dependas de trazas privadas de razonamiento del LLM como registro de auditoría. Un registro estructurado de decisiones es más útil para depuración, reproducibilidad y revisión independiente.
18. Pruebas comparativas: cómo demostrar que la plataforma funciona
Un framework que produce muchos hallazgos no necesariamente es un buen pentester. Puede generar falsos positivos, duplicados o hallazgos que no se pueden reproducir.
Evalúa el sistema contra aplicaciones con vulnerabilidades conocidas y resultados esperados.
18.1 Entorno de pruebas controlado
OWASP Juice Shop es una aplicación web deliberadamente vulnerable que incluye una amplia variedad de debilidades de seguridad y está diseñada para capacitación y evaluación de herramientas. Es un punto de partida útil porque permite probar frontends con mucho JavaScript y API REST.
Complementa el entorno con otras aplicaciones de laboratorio autorizadas y casos diseñados específicamente para autorización, autenticación, flujos con estado y aislamiento entre tenants.
Mantén un catálogo de referencia que registre:
- Vulnerabilidad conocida.
- Endpoint o flujo afectado.
- Identidad y estado requeridos.
- Prerrequisitos esperados.
- Método seguro de reproducción.
- Evidencia esperada.
- Limitaciones conocidas.
La base de referencia debe verificarse de forma independiente y mantenerse versionada.
18.2 Métricas cuantitativas
| Métrica | Propósito |
|---|---|
| Precisión | Proporción de hallazgos positivos reportados que son correctos |
| Exhaustividad (recall) | Proporción de vulnerabilidades conocidas y aplicables que se detectan |
| Tasa de falsos positivos | Frecuencia de clasificaciones positivas incorrectas |
| Cobertura de endpoints | Proporción de endpoints aplicables conocidos que se alcanzaron o probaron |
| Cobertura de flujos | Proporción de flujos conocidos que se ejecutaron |
| Validez de la evidencia | Proporción de hallazgos que cumplen los criterios de validación |
| Reproducibilidad | Consistencia entre ejecuciones repetidas |
| Tasa de acciones duplicadas | Recursos desperdiciados por trabajo redundante |
| Violaciones de alcance | Acciones no autorizadas aceptadas o ejecutadas |
| Eficiencia de solicitudes | Solicitudes necesarias por hallazgo validado |
| Tiempo y costo | Eficiencia operativa |
| Tasa de recuperación | Manejo exitoso de fallos recuperables |
| Intervención humana | Frecuencia y motivo de la asistencia manual |
Para un conjunto definido de vulnerabilidades conocidas:
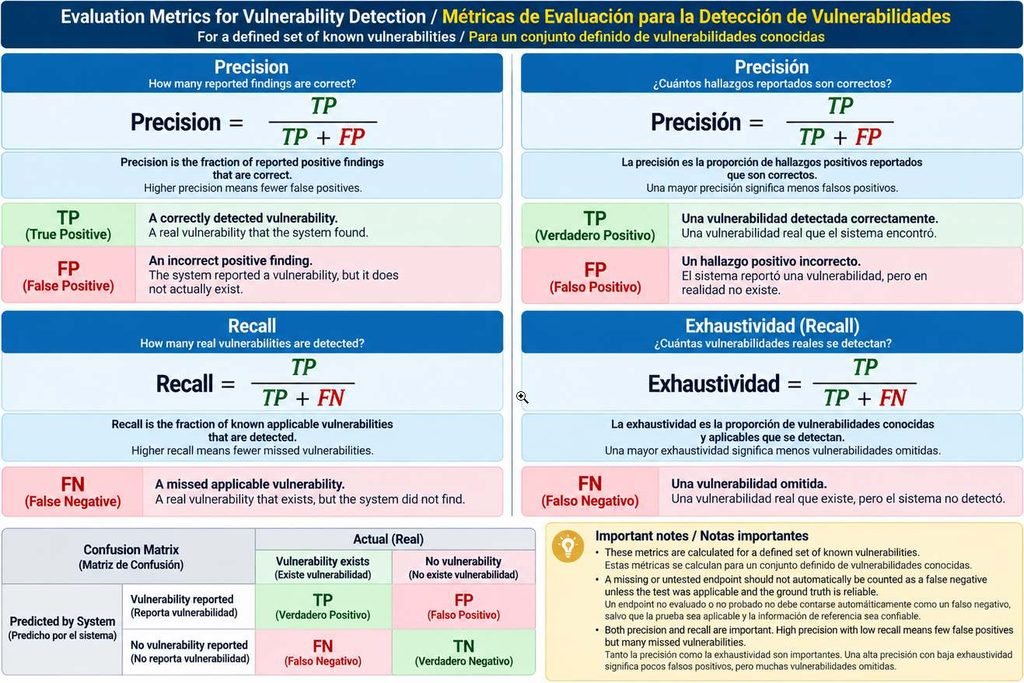
Donde (TP) representa una vulnerabilidad detectada correctamente, (FP) un hallazgo positivo incorrecto y (FN) una vulnerabilidad aplicable que no se detectó.
Un endpoint ausente del inventario o no probado no debe contabilizarse automáticamente como un falso negativo confirmado, salvo que la prueba de referencia establezca que era aplicable y que la información de referencia es confiable.
18.3 Pruebas de aceptación de seguridad
Antes de habilitar una autonomía significativa, verifica que:
- Se rechacen los destinos fuera de alcance.
- Las redirecciones no autorizadas no puedan eludir las comprobaciones.
- No puedan invocarse herramientas no registradas.
- Se apliquen los presupuestos de recursos.
- La inyección de prompts desde contenido del objetivo no pueda autorizar acciones prohibidas.
- Las credenciales no se filtren en registros generales o reportes.
- No se puedan recuperar datos de otras evaluaciones.
- La parada de emergencia revoque la capacidad de ejecución.
- Los flujos interrumpidos se recuperen sin repetir operaciones de forma insegura.
- Los hallazgos sigan siendo trazables hasta la evidencia.
La autonomía solo debe aumentar después de superar los controles de calidad y seguridad.
19. Decisiones de arquitectura
Las siguientes decisiones se recomiendan para una implementación inicial.
Decisión 1: ¿Flujo determinista o planificación impulsada por LLM?
Recomendación: Comenzar con orquestación determinista.
Es más fácil de probar, reproducir y restringir. Incorpora planificación mediante LLM después de que el modelo de evidencia, los adaptadores, la aplicación de políticas y los validadores sean confiables.
Cambia esta decisión cuando las pruebas comparativas demuestren que la planificación adaptativa descubre vulnerabilidades adicionales significativas sin un costo, falsos positivos o regresiones de seguridad inaceptables.
Decisión 2: ¿Un solo agente o una arquitectura multiagente?
Recomendación: Comenzar con un planificador y componentes especializados modulares.
Los agentes adicionales introducen coordinación, conflictos de estado, trabajo duplicado y depuración más compleja. Incorpora agentes separados solo cuando los experimentos demuestren un beneficio medible.
Decisión 3: ¿Herramientas existentes o scripts personalizados?
Recomendación: Preferir herramientas existentes para capacidades maduras y repetibles.
Los módulos personalizados se justifican para validación específica de aplicaciones, soporte de protocolos faltantes o flujos de trabajo que las herramientas existentes no cubran. Los scripts generados deben seguir siendo una excepción controlada.
Decisión 4: ¿Descubrimiento centrado en navegador o en protocolo?
Recomendación: Utilizar un enfoque híbrido.
El descubrimiento mediante navegador revela estados interactivos y tráfico real de API. Las pruebas directas de protocolo ofrecen mayor control y son más eficientes para comprobaciones repetibles. Ninguno de los dos enfoques es suficiente para todas las aplicaciones.
Decisión 5: ¿Pruebas automáticas o con aprobación humana?
Recomendación: Automatizar primero las pruebas reversibles y de bajo impacto.
Exige autorización adicional para pruebas con efectos secundarios importantes, comportamiento destructivo, consecuencias financieras o impacto operativo incierto. No confundas la autorización general para evaluar una aplicación con el permiso para realizar cualquier acción imaginable contra ella.
Decisión 6: ¿Validación mediante modelo o determinista?
Recomendación: Utilizar validación determinista siempre que sea práctico, respaldada por evidencia independiente y revisión humana en los casos ambiguos.
Un LLM puede ayudar a interpretar el contexto e identificar hipótesis alternativas, pero su nivel de confianza no debe considerarse una prueba.
Decisión 7: ¿Comprobaciones dentro del proceso o aplicación independiente de controles de red?
Recomendación: Utilizar controles independientes.
Las comprobaciones dentro de una herramienta o un planificador pueden eludirse por errores, procesos comprometidos o salidas incorrectas del modelo. Los controles de red y ejecución deben limitar lo que realmente puede hacer un worker.
20. Hoja de ruta de implementación por fases
La estrategia de desarrollo más segura y eficiente es incremental.
Fase 1: MVP determinista
Objetivo: Establecer una base confiable de ejecución y evidencia.
Construye:
- Manifiesto de evaluación y validación de alcance.
- Inventario básico de activos y endpoints.
- Cliente HTTP controlado.
- Descubrimiento mediante navegador.
- Un conjunto pequeño de módulos de prueba revisados.
- Registros estructurados de ejecución.
- Almacenamiento de evidencia.
- Esquemas de hallazgos y cobertura.
- Reportes básicos.
- Aislamiento de workers y parada de emergencia.
No requieras planificación autónoma ni scripts generados en esta fase.
Criterios de salida:
- Cada acción activa se verifica contra el alcance.
- Las solicitudes fuera de alcance se rechazan en pruebas negativas.
- La evidencia puede rastrearse mediante identificadores de ejecución.
- Los hallazgos pueden reproducirse manualmente.
- El sistema distingue casos confirmados, sospechosos, bloqueados y no probados.
- Los límites de recursos y la cancelación funcionan según lo diseñado.
Fase 2: Pruebas autenticadas y conscientes del estado
Objetivo: Modelar el comportamiento de la aplicación más allá de las URLs anónimas.
Agrega:
- Identidades de prueba autorizadas y matrices de roles.
- Gestión del ciclo de vida de las sesiones.
- Seguimiento del estado del navegador y de las API.
- Grafos de flujos de trabajo.
- Validadores de autorización.
- Adaptadores GraphQL y WebSocket cuando sean necesarios.
- Recuperación segura de sesiones expiradas y flujos interrumpidos.
Criterios de salida:
- El framework puede ejecutar flujos documentados bajo varias identidades autorizadas.
- Las pruebas de autorización comparan las observaciones con una política esperada.
- Los fallos de protocolos con estado se registran correctamente.
- La cobertura distingue entre comportamiento descubierto, alcanzado, ejercitado y validado.
Fase 3: Planificación agéntica acotada
Objetivo: Introducir toma de decisiones adaptativa.
Agrega:
- Un planificador que proponga acciones mediante la interfaz de herramientas registradas.
- Seguimiento de hipótesis e incertidumbre.
- Replanificación basada en evidencia.
- Lógica para eliminar duplicados y detener pruebas.
- Priorización basada en costos.
- Aprobación humana para acciones de mayor impacto.
El planificador no debe ejecutar comandos arbitrarios de shell ni anular decisiones de política.
Criterios de salida:
- El agente se adapta a observaciones nuevas o modificadas.
- Evita repetir acciones improductivas.
- Produce registros estructurados de decisiones.
- Mejora los resultados de las pruebas comparativas respecto a la línea base determinista.
- No degrada la seguridad ni la calidad de la evidencia.
Fase 4: Autonomía ampliada
Objetivo: Mejorar la profundidad y la eficiencia sin perder el control.
Considera incorporar:
- Agentes especializados para tareas realmente diferentes.
- Generación controlada de scripts.
- Más adaptadores de protocolo.
- Bibliotecas de playbooks más amplias.
- Planificación avanzada basada en grafos.
- Correlación más sofisticada de evidencia.
- Proveedores de modelos adicionales.
Cada capacidad debe incorporarse con sus propias pruebas, límites y criterios de liberación.
Criterios de salida:
- La nueva capacidad produce beneficios medibles.
- Sus modos de fallo están documentados.
- Su ejecución está acotada y es auditable.
- Sus hallazgos siguen siendo reproducibles.
- Las pruebas de parada de emergencia y aplicación del alcance continúan pasando.
21. Especificación técnica recomendada para el MVP
Una primera versión práctica puede utilizar los siguientes componentes.
| Capa | Opción inicial |
|---|---|
| API y plano de control | Servicio Python con modelos de entrada y salida tipados |
| Estado relacional | PostgreSQL o una base de datos relacional equivalente |
| Almacenamiento de artefactos | Almacenamiento de objetos con controles de acceso |
| Navegador | Playwright |
| Ejecución HTTP | httpx detrás de controles de red |
| Comprobaciones de seguridad iniciales | Capacidades seleccionadas de ZAP y módulos personalizados revisados |
| Ejecución de tareas | Cola asíncrona con límites |
| Aislamiento de workers | Contenedores dedicados o workers aislados equivalentes |
| Aplicación de políticas | Servicio de autorización separado más restricciones de salida de red |
| Validación | Funciones deterministas revisadas |
| Reportes | Hallazgos JSON estructurados y reportes legibles para personas |
| Monitoreo | Registros de ejecución, métricas, decisiones de política y eventos de error |
Estas son recomendaciones iniciales, no elecciones tecnológicas obligatorias. La arquitectura importa más que el framework o la base de datos específicos.
21.1 Ciclo de ejecución mínimo
1. Recibir la configuración de la evaluación
2. Validar la autorización y el alcance
3. Crear el estado de la evaluación
4. Descubrir activos aprobados
5. Validar cada candidato antes de realizar pruebas activas
6. Descubrir rutas y estados de la aplicación
7. Seleccionar un módulo de prueba aprobado
8. Enviar la acción a la aplicación de políticas
9. Ejecutar dentro del límite autorizado
10. Capturar y almacenar evidencia
11. Validar el resultado
12. Actualizar los estados de hallazgos y cobertura
13. Replanificar o detenerse según las políticas y los presupuestos
14. Generar el reporte
La primera versión debe poder ejecutar este ciclo sin un LLM.
Una vez que funcione de forma confiable, se puede introducir un LLM para mejorar la priorización y seleccionar entre acciones existentes. Esto permite medir si el modelo aporta valor real, en lugar de añadir complejidad sin demostrar beneficios.
22. Mejoras de ingeniería prioritarias
Cinco mejoras deben tener prioridad sobre agregar más agentes.
1. Aplicación del alcance que no pueda eludirse
Por qué: Un error de razonamiento no debe convertirse en una operación de red no autorizada.
Implementación: Aplicar de forma independiente las restricciones de destino, protocolos, puertos, redirecciones, presupuestos de recursos y permisos de herramientas.
Criterio de aceptación: Las pruebas adversariales que intenten salida directa a la red, redirecciones no autorizadas y ejecución de herramientas no registradas son rechazadas.
2. Validación independiente de la evidencia
Por qué: Una gran cantidad de hallazgos tiene poco valor si no pueden reproducirse.
Implementación: Crear validadores revisados para las clases de vulnerabilidades prioritarias, comenzando por fallos de autorización y problemas comunes de configuración o inyección.
Criterio de aceptación: Los hallazgos de referencia se evalúan contra una base conocida y se reportan por separado la precisión, la exhaustividad y la tasa de reproducción.
3. Descubrimiento autenticado y consciente del estado
Por qué: Los fallos de seguridad importantes suelen depender de roles, sesiones y estados de los flujos de trabajo.
Implementación: Registrar identidades, sesiones, rutas, objetos y transiciones en un modelo de estado persistente.
Criterio de aceptación: El framework puede documentar qué flujos autorizados y contextos de identidad fueron realmente probados.
4. Secretos y aislamiento entre evaluaciones
Por qué: Una plataforma de pruebas de penetración maneja credenciales y evidencia sensible de clientes potencialmente distintos.
Implementación: Utilizar referencias a secretos, redacción, controles de acceso, identificadores inmutables de evaluación y entornos de ejecución aislados.
Criterio de aceptación: Las pruebas negativas no pueden recuperar artefactos de otra evaluación ni exponer secretos mediante el contexto del modelo, los registros o los reportes.
5. Autonomía basada en pruebas comparativas
Por qué: Un comportamiento más adaptativo no necesariamente produce mejores pruebas.
Implementación: Comparar los modos determinista y agéntico utilizando la misma suite de referencia versionada.
Criterio de aceptación: La planificación adaptativa mejora las métricas relevantes de detección o cobertura sin infringir los controles de seguridad ni degradar significativamente la reproducibilidad.
23. Preguntas de ingeniería pendientes
Algunas decisiones dependen del entorno de despliegue y no pueden resolverse únicamente mediante principios generales de arquitectura.
Antes de implementar, determina:
- ¿El framework será de un solo tenant, estará alojado internamente o funcionará como un servicio comercial multi-tenant?
- ¿Qué proveedores de modelos y modalidades de despliegue están permitidos?
- ¿Los clientes proporcionarán credenciales, matrices de identidades o especificaciones de aplicaciones?
- ¿Qué operaciones de prueba requieren aprobación humana explícita?
- ¿Qué nivel de pruebas en producción está autorizado?
- ¿Qué protocolos deben admitirse en la primera versión?
- ¿Cuáles son los objetivos de concurrencia, costo y tiempo de ejecución?
- ¿Durante cuánto tiempo debe conservarse la evidencia y quién puede acceder a ella?
- ¿Qué jurisdicciones y requisitos contractuales son aplicables?
- ¿Qué clases de vulnerabilidad deben validarse de forma independiente antes de reportarse?
- ¿Qué mejora de rendimiento justificaría introducir planificación agéntica?
- ¿Qué evidencia se necesita antes de declarar que la plataforma está lista para producción?
Las pruebas externas de caja negra no pueden evaluar de manera concluyente todos los controles internos. La composición del software, la lógica del código fuente, la configuración interna de IAM, la calidad de los registros y la segmentación privada de red pueden requerir acceso al código, instrumentación o evaluaciones separadas.
El sistema de reportes debe indicar estas limitaciones claramente.
24. Recomendaciones finales
Una plataforma de pruebas de penetración verdaderamente agéntica no debe diseñarse como un LLM sin restricciones que tiene acceso a una terminal y a una colección de herramientas ofensivas.
Debe diseñarse como un sistema de pruebas de seguridad acotado, en el que el razonamiento adaptativo opere dentro de límites aplicados de manera independiente.
La secuencia de desarrollo recomendada es:
- Construir una base confiable de descubrimiento y ejecución deterministas.
- Establecer un mapeo de aplicaciones consciente del estado.
- Implementar validadores de evidencia revisados.
- Aplicar controles de alcance, aislamiento, presupuestos, gestión de secretos y parada de emergencia.
- Evaluar el sistema contra vulnerabilidades conocidas.
- Introducir planificación adaptativa acotada.
- Ampliar la autonomía únicamente cuando los resultados medidos lo justifiquen.
La distinción arquitectónica más importante está entre el componente que decide qué investigar y el componente que determina qué está permitido hacer.
El planificador puede estar equivocado, ser manipulado o cometer errores. El límite de autorización debe seguir funcionando. Una herramienta puede fallar; el sistema no debe interpretar ese fallo como evidencia de seguridad. Un modelo puede proponer una vulnerabilidad convincente; el sistema de validación debe seguir exigiendo evidencia reproducible.
Si estos principios se implementan correctamente, la plataforma resultante podrá evolucionar desde el escaneo determinista hasta las pruebas de penetración adaptativas sin sacrificar el control, la reproducibilidad ni la auditabilidad.
El objetivo no es crear el agente más autónomo posible. Es crear el agente más capaz cuyas acciones, hallazgos y limitaciones puedan verificarse de manera independiente.
Es especialista en ciberseguridad con más de 16 años de experiencia en seguridad de la información. Conoce muy bien la inteligencia de amenazas, la gestión de riesgos, la evaluación de vulnerabilidades y las pruebas de penetración, el análisis forense cibernético y la tecnología de seguridad en la nube (AWS, Azure, Google Cloud). Ocupó varios puestos de investigador de ciberseguridad en diferentes empresas. Tiene experiencia en diferentes industrias como finanzas, atención médica, marketing, gobierno, finanzas turísticas, aerolíneas, telecomunicaciones y biometría.